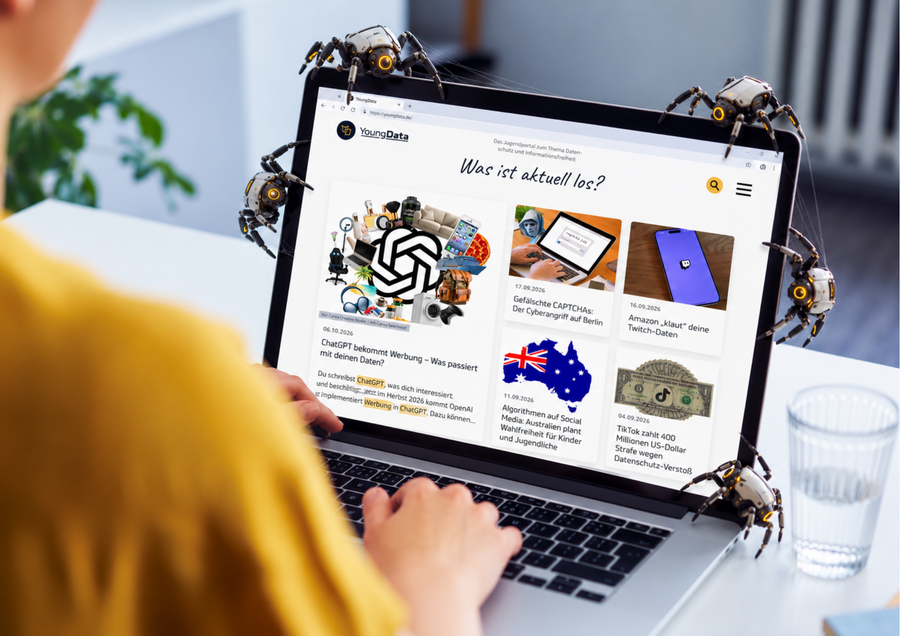
Webcrawler sind digitale Sammler, die das Internet systematisch nach Bildern und Texten durchforsten und scannen, um die frei zugänglichen Inhalte zur weiteren Verwendung zu sammeln. Viele moderne KI-Systeme und Bildgeneratoren werden unter anderem mit großen Mengen an Daten aus dem Internet trainiert. Ist vielleicht auch dein Foto darunter?
Was sind überhaupt Webcrawler? Webcrawler sind kleine digitale Roboter beziehungsweise Programme mit einem Suchauftrag. Manchmal nennt man sie auch Spider. Wie Spinnen rennen sie schnell und emsig durch das Netz, suchen nach Inhalten und speichern diese ab. Klassische Crawler bringen zum Beispiel Suchmaschinen die nötigen Daten, um Websites zu finden. KI-Crawler haben ein anderes Ziel: Sie sammeln massenhaft Bilder, Texte und Videos, die zum Trainieren von KI-Modellen verwendet werden. Manche Crawler ahmen menschliches Verhalten nach, simulieren unsere Surfgeschwindigkeit und Klickmuster und kommen so an die gewünschten Trainingsdaten. So greifen sie unbemerkt Daten ab. Ohne deine Zustimmung und ohne dich dafür zu bezahlen.
Der Fall von Elisa Harlans Bild
Eine schöne Erklärung bietet das Experiment „Der Rohstoff der KI sind wir“ von Katharina Brunner und Elisa Harlan, das auch den DAME-Preis 2023 gewonnen hat. Sie sind in ihrer Datenanalyse der Frage nachgegangen, wie Crawler Bilder und Texte von Millionen Websites als Trainingsdaten für KI-Systeme nutzen. Wurde mein Foto benutzt, um eine KI zu trainieren? Elisa Harlan vom Bayerischen Rundfunk wollte das herausfinden. Sie suchte in LAION-5B. Das ist ein Datensatz mit rund 5,85 Milliarden Bild-Text-Paaren, der unter anderem Verweise auf online verfügbare Bilder enthält. Damit wurde unter anderem der KI-Bildgenerator Stable Diffusion trainiert. Gefunden hat sie in den über 150 Millionen Bildverweisen nicht nur ein Foto von sich selbst – sondern auch Nacktbilder, Kontodaten und sogar das Foto eines Kindes mit genauen Standortdaten und Adressangabe.
LAION-5B wird von einem gemeinnützigen Verein bereitgestellt und ist vergleichsweise transparent. Deswegen konnte Harlan ihr Foto überhaupt finden. Die großen KI-Anbieter wie Google, OpenAI und Meta hingegen möchten in der Regel nicht verraten, woher ihre Trainingsdaten stammen. Niemand weiß, welche deiner Fotos mit Webcrawlern auch bei Social Media aufgesammelt und der KI zum Training zur Verfügung gestellt wurden. Interessant ist auch die Erkenntnis aus dem Experiment, dass du davon ausgehen sollst bzw. damit sogar rechnen sollst, dass jemand deine veröffentlichten Inhalte nehmen und anders verwenden kann.
Spinnen bleiben bitte draußen!
Deine eigene Webseite kannst du schützen: Mit einer robots.txt-Datei kannst du Webcrawler anweisen, bestimmte Bereiche deiner Webseite nicht aufzurufen. Einen zuverlässigen Zugriffsschutz bietet sie allerdings nicht. Das Problem: Viele Spider halten sich nicht daran. Auch die Terms of Service werden oft ignoriert. Bei Social Media gelten die „Hausregeln“ der Plattformbetreiber. Deine öffentlichen Fotos auf Instagram, TikTok oder X werden regelmäßig abgegriffen. Meta sammelt beispielsweise seit Mai 2025 öffentliche Instagram- und Facebook-Inhalte deutscher Nutzer:innen für KI-Training. Du musst aktiv widersprechen, wenn du das nicht willst: Nach dem Prinzip, wenn du dich um deine Daten nicht kümmerst, können sie alles von dir nehmen.
Überlege dir, was du öffentlich teilst oder ob es für dich okay ist, wenn KI mit deinen Daten trainiert wird und du sie somit kostenlos verbesserst. Lies die Datenschutzbestimmungen, auch wenn es keinen Spaß macht oder sich mühsam anfühlt – du entdeckst bestimmt Perlen, die dir in Erinnerung bleiben und dich davon abhalten, ohne Bedenken alles zur Verfügung zu stellen. Versuche, Dienste mit europäischen Servern zu nutzen. Mit den richtigen Datenschutzeinstellungen kannst du die Verwendung deiner Inhalte für das KI-Training bei bestimmten Anbietern einschränken.
Hier sind einige Beispiele für Einstellungen, die du schnell vornehmen kannst:
Bei Meta (Instagram/Facebook):
Einstellungen → Daten und Datenschutz → KI-Training → Widerspruch einreichen
Bei TikTok:
Profil → Einstellungen → Datenschutz → KI und Datenverwendung → ablehnen
Bei X (Twitter):
Profil auf privat stellen
Bei OpenAI:
In der App unter Einstellungen → Datenkontrollen → Modell für alle verbessern → deaktivieren

 Leichte Sprache